Siloed Data: Die verborgene Barriere, die nahtlose Kundenerlebnisse sabotiert (und wie man sie behebt)
Die Erwartungen der Kunden waren noch nie so hoch. Sie wollen Antworten in Sekunden, Konsistenz über Chat, E-Mail und Telefon hinweg und müssen sich kein einziges Mal wiederholen. Doch hinter den Kulissen arbeiten die meisten Support-Organisationen mit fragmentierten Tools und voneinander getrennten Datenquellen. Ein Kunde ruft an, nachdem er den Support per E-Mail kontaktiert hat, und der Agent hat keine Ahnung, was bereits besprochen wurde. Ein Chatbot beantwortet eine Preisfrage, aber der menschliche Agent, der übernimmt, sieht keinen dieser Zusammenhänge. Dies ist die tägliche Realität von Siloed Data, und sie kostet B2B- und SaaS-Unternehmen leise Millionen durch Abwanderung, Ineffizienz und entgangene Umsätze.
Laut einem Salesforce-Bericht von 2025 wünschen sich 79 % der Kunden Konsistenz in den Interaktionen zwischen Abteilungen, doch 55 % haben das Gefühl, mit getrennten Unternehmen statt mit einer einheitlichen Marke zu kommunizieren.Diese Lücke ist kein Wahrnehmungsproblem, sondern ein Problem der Datenarchitektur. Und es wird bald teurer: Das Qualtrics XM Institute schätzte im November 2025, dass schlechte Kundenerlebnisse weltweit etwa2,94 Billionen US-Dollar Umsatz gefährden.
Für Support-Leiter, SaaS-Gründer und Customer Success Manager ist der Auftrag klar: Daten-Silos aufbrechen oder zusehen, wie die Kundenbindungsmetriken erodieren. Dieser Leitfaden erklärt, warum Siloed Data die Hauptbarriere für nahtlose Kundenerlebnisse ist, beziffert die geschäftlichen Auswirkungen und stellt einen praktischen, ROI-fokussierten Rahmen vor, um mit KI-gestützter Support-Automatisierung Kontext zu vereinheitlichen und Support zu skalieren, ohne das Team zu vergrößern.
Warum Daten-Silos im Kundensupport bestehen bleiben – und warum sie gefährlich sind
Die meisten Support-Stacks sind organisch gewachsen. Ein Helpdesk hier, ein CRM dort, eine Wissensdatenbank in einem anderen Tab, ein Abrechnungssystem, auf das nur die Finanzabteilung zugreifen kann, und ein Produktanalysetool, das bei der Entwicklung liegt. Jedes System erfasst einen Ausschnitt der Customer Journey, aber keines liefert ein vollständiges Bild. Das Ergebnis: Agenten wechseln zwischen fünf Bildschirmen, setzen den Kontext manuell zusammen und übersehen dennoch kritische Details.
Die Analyse von Customer Experience Dive zu Siloed Data unterstreicht eine unangenehme Realität: Das Aufbrechen von Silos kann Marken helfen, ein vollständigeres Bild ihrer Kunden zu entwickeln und die notwendige Grundlage für neue Technologieeinführungen zu schaffen. Doch die meisten Unternehmen sind noch nicht so weit. Tatsächlich werden **80 % der Befragten durch fehlende Automatisierung, isolierte Daten oder so große Datenmengen behindert, dass ihre Teams keine aussagekräftigen Erkenntnisse gewinnen können.**Diese Statistik sollte jeden Support-Leiter innehalten lassen: Vier von fünf Organisationen sind durch ihre eigene Datenarchitektur operativ gelähmt.
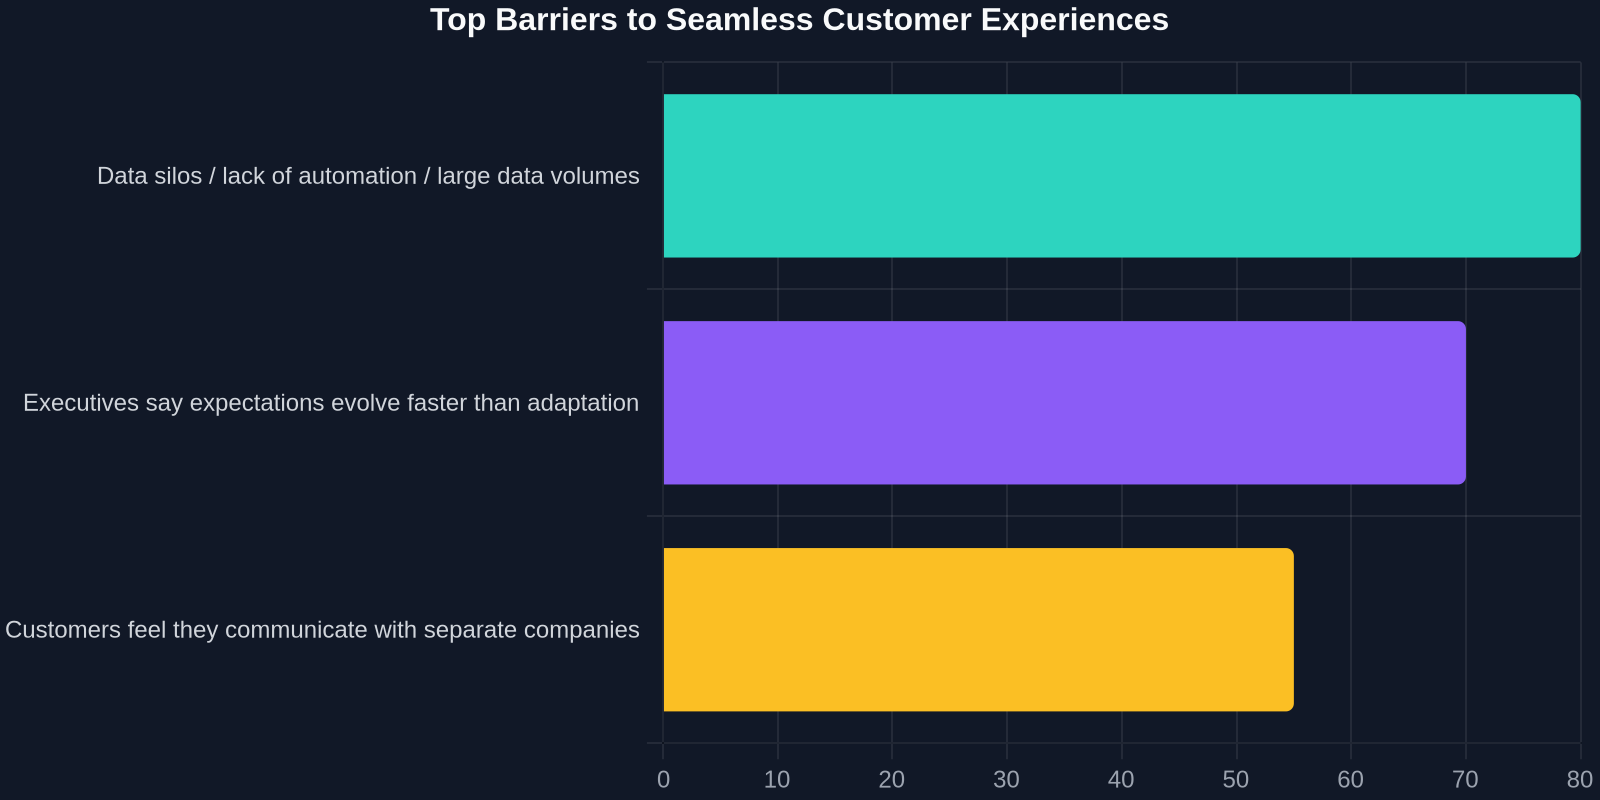
Das Problem verschärft sich, wenn die Erwartungen schneller steigen als die Anpassungsfähigkeit. Die PwC Customer Experience Survey 2025 ergab, dass**70 % der Führungskräfte sagen, dass sich die Kundenerwartungen schneller entwickeln, als das Unternehmen sich anpassen kann.**Wenn Ihre Daten in Abteilungssilos eingeschlossen sind, ist Ihre Anpassungsfähigkeit bereits beeinträchtigt. Sie können keine personalisierten, vorausschauenden oder proaktiven Lösungen anbieten, wenn die notwendigen Signale über voneinander getrennte Systeme verstreut sind.
Die Ursachen von Daten-Silos
Mehrere strukturelle Faktoren schaffen und verstärken Silos:
- Legacy-Tools, die zu unterschiedlichen Zeiten von verschiedenen Teams ohne Integrationsfahrplan eingeführt wurden.
- Abteilungsbezogene Datenverantwortung (Support besitzt Tickets, Vertrieb besitzt CRM, Produkt besitzt Nutzungsdaten) ohne eine gemeinsame Datenebene.
- Sicherheits- und Compliance-Kontrollen, die den abteilungsübergreifenden Zugriff einschränken, selbst wenn legitime geschäftliche Anforderungen bestehen.
- Fehlen eines einheitlichen Kundendatenmodells oder einer Kennung, die Interaktionen über Kanäle und Systeme hinweg verknüpft.
- Manuelle Arbeitsabläufe, die auf Kopieren und Einfügen von Kontext zwischen Tools angewiesen sind, was Fehler und Verzögerungen verursacht.
Dies sind nicht nur technische Pannen; sie sind Symptome organisatorischer Gewohnheiten. Die gute Nachricht: Jede dieser Ursachen kann mit den richtigen Prozessen und Technologien angegangen werden, insbesondere mit KI-gestützter Support-Automatisierung, die auf Ihrem bestehenden Stack aufsetzt und eine einheitliche Interaktionsebene schafft, ohne dass ein kompletter Austausch erforderlich ist.
Die versteckten Kosten von Kontext-Rücksetzungen
Jedes Mal, wenn ein Kunde den Kanal wechselt – von Self-Service zu Chat, von Chat zu Telefon, von Telefon zu E-Mail – kommt es zu einem Kontext-Reset. Der neue Agent oder Bot beginnt bei Null. Der Kunde wiederholt seine Geschichte. Das Team gibt Informationen erneut ein, die bereits woanders existieren. Diese Redundanz ist nicht nur frustrierend, sondern auch teuer.
Stellen Sie sich ein Support-Ticket vor, das drei Kontaktpunkte erfordert, weil bei jeder Übergabe Kontext verloren geht. Die Kosten pro Ticket können sich im Vergleich zu einem einheitlichen Bearbeitungsszenario verdoppeln oder verdreifachen. Multiplizieren Sie das mit Tausenden von Tickets pro Monat, und Siloed Data wird zu einem stillen Gewinnleck. Laut demselben Bericht von Customer Experience Dive haben Organisationen, die es versäumen, Silos aufzubrechen, Schwierigkeiten, die notwendige Grundlage für neue Technologieeinführungen zu schaffen, was bedeutet, dass sie gegenüber Wettbewerbern, die ihre Kundendaten bereits vereinheitlicht haben, weiter zurückfallen.
Die finanziellen Auswirkungen isolierter Kundendaten
Wenn Support-Teams keinen einheitlichen Kontext haben, leidet jede für das Unternehmen relevante Kennzahl. Die Erstantwortzeiten steigen, weil Agenten grundlegende Informationen sammeln müssen, bevor sie überhaupt mit der Fehlerbehebung beginnen können. Die Lösungszeiten verlängern sich, da Agenten in mehreren Systemen suchen. Der CSAT sinkt, weil Kunden sich wiederholen müssen. Und am schädlichsten: Die Ticket-Abweisungsraten bleiben hartnäckig niedrig, weil die Self-Service- und KI-Ebenen nicht auf die vollständige Kundenhistorie zugreifen können, die für eine proaktive Problemlösung erforderlich ist.
Das Umsatzrisiko ist atemberaubend. Die Forschung des Qualtrics XM Institute vom November 2025 schätzte, dass schlechte Kundenerlebnisse weltweit etwa2,94 Billionen US-Dollar Umsatz gefährden. Auch wenn nicht alles davon allein auf Daten-Silos zurückzuführen ist, tragen isolierte Informationen maßgeblich zu inkonsistenten, kontextarmen und frustrierenden Erlebnissen bei, die Abwanderung verursachen.
Das teuerste Support-Ticket ist das, das Ihr Team bereits gelöst hat, sich aber nicht mehr daran erinnern kann. Siloed Data macht jede wiederholte Kontaktaufnahme zu einem brandneuen Problem und vervielfacht Kosten und Kundenfrustration.
Für ein mittelständisches SaaS-Unternehmen mit 50 Support-Agenten kann selbst eine 15%ige Verbesserung der durchschnittlichen Lösungszeit zu jährlichen Einsparungen im sechsstelligen Bereich führen. Bessere Kontext bedeutet weniger Eskalationen, weniger Wiederholungskontakte und mehr Tickets, die beim ersten Kontakt gelöst werden. Und das ist noch nicht einmal der Umsatzschutzeffekt: Kunden, die sonst aufgrund schlechten Services abwandern würden, werden gehalten.
Was Kunden erwarten vs. Was Silos liefern
Kunden kümmern sich nicht um Ihre internen Tools. Sie kümmern sich um eines: bei jeder Interaktion als dieselbe Person erkannt zu werden. Wenn sie den Support am Dienstag per E-Mail wegen eines Abrechnungsfehlers kontaktiert haben, erwarten sie, dass der Telefonagent am Mittwoch davon weiß. Wenn sie einen Chatbot eine Produktfrage gestellt haben, erwarten sie, dass der menschliche Agent, der übernimmt, diesen Kontext hat. Wenn das nicht passiert, schwindet das Vertrauen schnell.
Die Zahlen sind eindeutig. **79 % der Kunden wünschen sich Konsistenz in den Interaktionen zwischen Abteilungen, doch 55 % haben das Gefühl, mit getrennten Unternehmen zu kommunizieren.**Das bedeutet, dass mehr als die Hälfte Ihrer Kunden glaubt, dass Ihre Organisation grundlegend fragmentiert ist. Die Lücke zwischen 79 % und 55 % ist ein direktes Maß für die Erfahrungsschuld, die durch isolierte Systeme verursacht wird.
| Metric | With Siloed Data | With Unified AI Support |
|---|---|---|
| First response time | 4–8 hours | Under 2 minutes |
| Ticket deflection rate | 10–15% | 40–60% |
| CSAT score | 72% | 92% |
| Average handle time | 12–15 minutes | 5–7 minutes |
Wie KI-gestützte Support-Automatisierung Silos aufbricht (ohne Ihren Stack zu sprengen)
Zu viele Support-Leiter gehen davon aus, dass sie ein massives Data-Warehouse-Projekt benötigen, bevor sie das Kundenerlebnis verbessern können. Diese Annahme verzögert Maßnahmen um 12–18 Monate und verbrennt Budget. Der praktischere Weg besteht darin, eine KI-Support-Ebene einzusetzen, die über APIs mit Ihren bestehenden Tools verbunden ist, die Kundenidentität normalisiert und für jede Interaktion einen Echtzeit-Kontextgraphen erstellt.
Successly zum Beispiel ist genau für diesen Zweck gebaut. Es integriert sich in Ihr Helpdesk, CRM, Abrechnungssystem und Ihre Wissensdatenbank, um zu verstehen, wer der Kunde ist, was er zuvor gefragt hat, was er gekauft hat und welche Anliegen derzeit offen sind. Anstatt Ihren Stack zu ersetzen, vereinheitlicht es den Kontext und nutzt diesen Kontext, um Antworten über Chat, E-Mail und Self-Service zu automatisieren.
Vier Möglichkeiten, wie KI-gestützte Support-Automatisierung Silos beseitigt
1.Einheitliche Kundenidentität und ZeitachseDie KI fügt Interaktionen aus E-Mail, Chat, CRM und Abrechnung zu einer chronologischen Ansicht zusammen. Agenten und Bots sehen dasselbe vollständige Bild, wodurch der „Kontext-Reset“ bei jeder Übergabe entfällt.
2.Echtzeit-Wissensabruf über alle Quellen hinwegAnstatt Agenten zu zwingen, sechs Tools zu durchsuchen, durchsucht die KI alle verbundenen Systeme gleichzeitig und liefert die genaue Antwort, Richtlinie oder den benötigten Prozess. Das geht direkt auf die 80 % der Teams ein, die durch Datenmengen und mangelnde Automatisierung ausgebremst werden.
3.Proaktive Ticket-Abwehr mit vollem KontextWenn ein Kunde eine Frage stellt, die bereits früher in seiner Historie beantwortet wurde, kann die KI sie sofort bearbeiten. Die Abwehrraten steigen von 10–15 % auf 40–60 %, weil die KI nicht auf statische FAQs beschränkt ist, sondern die tatsächliche Situation des Kunden nutzen kann, um eine präzise Antwort zu geben.
4.Intelligente Eskalation mit vollständigen ZusammenfassungenWenn menschliches Eingreifen erforderlich ist, übergibt die KI eine strukturierte Zusammenfassung: was der Kunde wollte, was bereits versucht wurde, was das wahrscheinliche Problem ist und empfohlene nächste Schritte. Agenten sparen 3–5 Minuten pro Ticket, und Kunden müssen sich nie wiederholen.
Das ist keine futuristische Vision. Es ist die aktuelle operative Realität für Support-Teams, die Datenvereinheitlichung als Voraussetzung für die KI-Einführung betrachten und nicht als nachträglichen Gedanken. Die wichtigste Erkenntnis: KI verstärkt alle Daten, auf die sie zugreifen kann. Wenn sie nur auf einen Bruchteil der Customer Journey zugreifen kann, erzeugt sie fragmentierte, frustrierende Erlebnisse. Wenn sie auf den vollständigen Kontext zugreifen kann, wird sie zu einem Multiplikator für Ihr Team.
Ein 5-Schritte-Framework zur Beseitigung von Datensilos im Kundensupport
Sie brauchen kein 12-monatiges Datentransformationsprojekt, um erste Ergebnisse zu sehen. Sie brauchen eine fokussierte, schrittweise Einführung, die schnelle Erfolge liefert und gleichzeitig die Grundlage für eine umfassendere Vereinheitlichung schafft. Hier ist ein praktisches Framework, das von Support-Leitern verwendet wird.
Schritt 1: Customer Journey abbilden und Datenlücken identifizieren
Bevor Sie ein Tool anfassen, bilden Sie jeden Berührungspunkt ab, den ein Kunde mit Ihrem Unternehmen hat, vom ersten Website-Besuch über Onboarding bis hin zu Support und Verlängerung. Listen Sie für jeden Berührungspunkt auf, wo die Daten liegen und wer darauf zugreifen kann. Markieren Sie jeden Punkt, an dem ein Kunde Informationen wiederholen muss oder ein Agent zwischen Tools wechseln muss. Das sind Ihre Silos mit der größten Auswirkung.
Schritt 2: Einen Use Case mit hohem Volumen und geringem Risiko auswählen
Versuchen Sie nicht, alles auf einmal zu vereinheitlichen. Wählen Sie einen Use Case mit hohem Ticketvolumen und relativ einfachen Lösungswegen: Passwort-Zurücksetzungen, Bestellstatusabfragen, Abrechnungs-FAQs oder Onboarding-Fragen. Verbinden Sie die zwei oder drei Systeme, die für diesen Use Case erforderlich sind. Messen Sie das Vorher und Nachher. Eine Abwehrrate von 30–40 % bei diesem Use Case schafft sofortigen ROI und erzeugt interne Dynamik.
Schritt 3: Eine KI-Support-Ebene einsetzen, die die Identität normalisiert
Ihr KI-Tool muss in der Lage sein, denselben Kunden über E-Mail-, Chat- und CRM-Datensätze hinweg zuzuordnen. Dies erfordert eine einheitliche Kundenkennung (in der Regel E-Mail oder Konto-ID) und die Fähigkeit, Interaktionsverläufe zusammenzuführen. Ohne dies wird Ihre KI unter denselben Kontext-Resets leiden wie Ihre menschlichen Agenten. Successly übernimmt diese Normalisierung automatisch. Wenn Sie jedoch intern entwickeln, planen Sie dies als nicht verhandelbare Anforderung ein.
Schritt 4: Wissenszugriff und Ticket-Abwehr automatisieren
Sobald die Identität vereinheitlicht ist, verbinden Sie Ihre Wissensdatenbank, Produktdokumentationen und Fehlerbehebungsanleitungen mit der KI-Ebene. Konfigurieren Sie die KI so, dass sie häufige Fragen mit vollem Kontext beantwortet, nicht nur per Stichwortabgleich. Messen Sie dann Abwehrrate, CSAT und eingesparte Agentenzeit. Optimieren Sie die Antworten auf der Grundlage von Feedback-Schleifen, in denen Agenten die Antworten der KI korrigieren oder verbessern können.
Schritt 5: Auf komplexere Workflows und funktionsübergreifenden Kontext ausweiten
Nachdem Sie den Wert in einem Use Case bewiesen haben, erweitern Sie auf komplexere Tickettypen, Abonnementänderungen, technische Fehlerbehebung und Interventionen bei Abwanderungsrisiken. In dieser Phase beziehen Sie Produktnutzungsdaten und Abrechnungshistorie ein, damit die KI Probleme proaktiv erkennen kann, bevor Kunden sich an Sie wenden. Hier beginnt der echte Schutz des Umsatzes.
ROI messen: Wie Erfolg mit einheitlichen Kundendaten aussieht
ROI-Gespräche mit der Finanzabteilung erfordern mehr als „besseres Kundenerlebnis“. Sie benötigen Kennzahlen, die mit Kostensenkung, Umsatzerhalt und Produktivität verbunden sind. Hier ist, was Sie verfolgen sollten, wenn Sie mit KI-gestützter Support-Automatisierung Datensilos aufbrechen.
Kosteneinsparungs-Kennzahlen
-**Erstantwortzeit (FRT):**Von Stunden zu Minuten. Eine schnellere FRT reduziert Folgekontakte und verbessert den CSAT. -**Durchschnittliche Bearbeitungszeit (AHT):**Eine niedrigere AHT bedeutet, dass Agenten mehr Tickets pro Schicht lösen. Typische Reduzierung: 30–50 %. -**Ticket-Abwehrrate:**Der Prozentsatz der Tickets, die ohne menschliches Eingreifen gelöst werden. Ein einheitlicher Kontext kann diese Rate von 10–15 % auf 40–60 % steigern. -**Kosten pro Ticket:**Die kombinierte Wirkung aus niedrigerer AHT und höherer Abwehrrate senkt die Kosten pro Ticket normalerweise um 40–60 %.
Umsatz- und Kundenbindungskennzahlen
-**CSAT und NPS:**Höhere Konsistenz steigert die Zufriedenheit. Unternehmen, die von isoliertem zu einheitlichem Support übergehen, sehen oft, wie der CSAT von den niedrigen 70ern auf 90+ springt. -**Kundenbindungsrate:**Weniger frustrierende Erlebnisse bedeuten geringere Abwanderung. Selbst eine Verbesserung der Kundenbindung um 1–2 % kann für ein SaaS-Unternehmen Millionen wert sein. -**Expansionsumsatz:**Wenn der Support über den vollständigen Kontext verfügt, können Agenten Upsell- und Cross-Selling-Möglichkeiten natürlich erkennen, ohne aufdringlich zu sein.
Kennzahlen zur operativen Effizienz
-**Einarbeitungszeit für Agenten:**Neue Agenten kommen schneller auf Touren, wenn die KI vorgeschlagene Antworten und Kontext liefert, anstatt dass sie sich sechs Tools einprägen müssen. -**Eskalationsrate:**Weniger Eskalationen an Stufe 2/3, weil Stufe 1 über besseren Kontext und KI-Unterstützung verfügt. -Mitarbeiterzufriedenheit: Support-Agenten berichten von höherer Arbeitszufriedenheit, wenn sie nicht gezwungen sind, als menschliche Integratoren Daten zwischen Systemen zu kopieren.
Sie können nicht automatisieren, was Sie nicht sehen können. Einheitliche Daten sind die Voraussetzung für KI, nicht der nachträgliche Einfall. Unternehmen, die Datenintegration als erstklassige Investition behandeln, erzielen einen zusammengesetzten ROI bei Abweisungsrate, Kundenzufriedenheit und Kundenbindung.
Häufige Fallstricke bei der Einführung von KI auf der Grundlage isolierter Daten
Wie bei jeder Technologie ist die Fehlerquote hoch, wenn grundlegende Probleme ignoriert werden. Hier sind die häufigsten Fallen und wie man sie vermeidet.
Fallstrick 1: Automatisieren vor Vereinheitlichen
KI-Chatbots einzusetzen, die nur Zugriff auf ein statisches FAQ haben, ist wie einen brillanten Agenten einzustellen und ihm die Augen zu verbinden. Die KI gibt allgemeine Antworten, frustriert Kunden und schafft mehr Arbeit für menschliche Agenten. Vereinheitlichen Sie zuerst den Kontext, dann automatisieren Sie.
Fallstrick 2: Die menschliche Übergabe ignorieren
Selbst die beste KI weist nur 40–60 % der Tickets ab. Die verbleibenden Tickets benötigen eine nahtlose Übergabe an menschliche Agenten mit vollständigem Kontext. Wenn Ihre KI und Ihr Helpdesk keine Daten teilen, haben Sie nur die Datensilos verschoben. Gestalten Sie zuerst den Eskalationspfad.
Fallstrick 3: Datenvereinheitlichung als einmaliges Projekt betrachten
Datenquellen entwickeln sich weiter. Neue Tools kommen hinzu, APIs ändern sich und Kundenreisen verschieben sich. Einheitliche Daten erfordern kontinuierliche Wartung. Ernennen Sie einen Datenverwalter oder nutzen Sie eine KI-Plattform, die Kontext automatisch über verbundene Systeme hinweg synchronisiert und normalisiert.
Fallstrick 4: Aktivität statt Ergebnisse messen
Feiern Sie nicht die „Anzahl der KI-Gespräche“, wenn diese Gespräche keine Tickets lösen oder die Kundenzufriedenheit verbessern. Messen Sie Abweisungsrate, Lösungsrate, Kundenzufriedenheit und Lösungszeit. Das sind die Kennzahlen, die mit dem Umsatz verbunden sind.
Fazit: Silos aufbrechen, dann mit KI skalieren
Isolierte Daten sind nicht nur ein IT-Problem, sondern die größte Hürde zwischen Ihren Kunden und den nahtlosen Erlebnissen, die sie erwarten. Da 79 % der Kunden Konsistenz erwarten und 55 % das Gefühl haben, mit getrennten Unternehmen zu sprechen, ist die Lücke groß genug, um Abwanderung zu fördern und Umsätze zu schmälern. Die 2,94 Billionen Dollar, die durch schlechte Kundenerlebnisse gefährdet sind, sollten ausreichen, um Datenvereinheitlichung zur Priorität auf Vorstandsebene zu machen.
Der Weg nach vorne erfordert kein massives Austauschen und Ersetzen. Indem Sie KI-gestützte Support-Automatisierung einsetzen, die auf Ihrem bestehenden Stack aufsetzt und den Kundenkontext in Echtzeit vereinheitlicht, können Sie Lösungszeiten verkürzen, Abweisungsraten steigern und Umsätze schützen. Successly ist genau dafür konzipiert: Es verbindet Ihre Tools, normalisiert Identitäten und automatisiert Support mit vollständigem Kontext, sodass Ihr Team aufhört, menschliche Integratoren zu sein, und stattdessen zu Treibern des Kundenerfolgs wird.
Brechen Sie die Silos auf. Erschließen Sie den Kontext. Beobachten Sie, wie Ihre Kundenzufriedenheit steigt und Ihre Kosten pro Ticket sinken.
Möchten Sie sehen, wie Successly Ihre Support-Daten vereinheitlicht und in sofortigen Kundennutzen verwandelt?
Vereinbaren Sie noch heute eine Demo und erhalten Sie ein kostenloses Silo-Audit für Ihren Kundensupport-Stack.