Разрозненные данные: скрытый барьер, подрывающий безупречный клиентский опыт (и как это исправить)
Ожидания клиентов никогда не были такими высокими. Они хотят получать ответы за секунды, стабильность в чате, электронной почте и по телефону, и им не нужно повторять себя. Однако за кулисами большинство служб поддержки работают на разрозненных инструментах и несвязанных источниках данных. Клиент звонит после того, как написал в поддержку по электронной почте, а агент понятия не имеет, что уже обсуждалось. Чат-бот отвечает на вопрос о цене, но человек-агент, который подхватывает разговор, не видит этого контекста. Это повседневная реальность разрозненных данных, и она тихо обходится B2B и SaaS-компаниям в миллионы из-за оттока клиентов, неэффективности и упущенной выручки.
Согласно отчету Salesforce за 2025 год, 79% клиентов хотят стабильности во взаимодействиях между отделами, но 55% чувствуют, что общаются с разными компаниями, а не с единым брендом.Этот разрыв — не проблема восприятия, это проблема архитектуры данных. И она становится дороже: Qualtrics XM Institute оценил в ноябре 2025 года, что плохой клиентский опыт поставит под угрозу примерно2,94 триллиона долларов глобальной выручки.
Для руководителей поддержки, основателей SaaS и менеджеров по успеху клиентов задача ясна: разрушьте разрозненные данные или наблюдайте, как ваши показатели удержания ухудшаются. Это руководство объясняет, почему разрозненные данные являются главным барьером для безупречного клиентского опыта, количественно оценивает бизнес-влияние и предлагает практическую, ориентированную на ROI структуру для использования AI-автоматизации поддержки, чтобы объединить контекст и масштабировать поддержку без увеличения штата.
Почему разрозненные данные сохраняются в поддержке клиентов и чем они опасны
Большинство стеков поддержки росли органически. Где-то хелпдеск, где-то CRM, база знаний в другой вкладке, биллинговая система, доступная только финансам, и инструмент аналитики продукта, который живет у инженеров. Каждая система захватывает часть пути клиента, но ни одна не дает полной картины. Результат: агенты переключаются между пятью экранами, вручную собирают контекст и все равно упускают критические детали.
Анализ разрозненных данных от Customer Experience Dive подтверждает суровую реальность: разрушение барьеров может помочь брендам получить более полную картину своих клиентов и создать необходимую основу для внедрения новых технологий. Однако большинство компаний до этого не дошли. Фактически, **80% респондентов сталкиваются с препятствиями из-за отсутствия автоматизации, разрозненных данных или таких больших объемов данных, что их команды не могут извлечь значимую информацию.**Эта статистика должна остановить каждого руководителя поддержки: четыре из пяти организаций операционно парализованы собственной архитектурой данных.
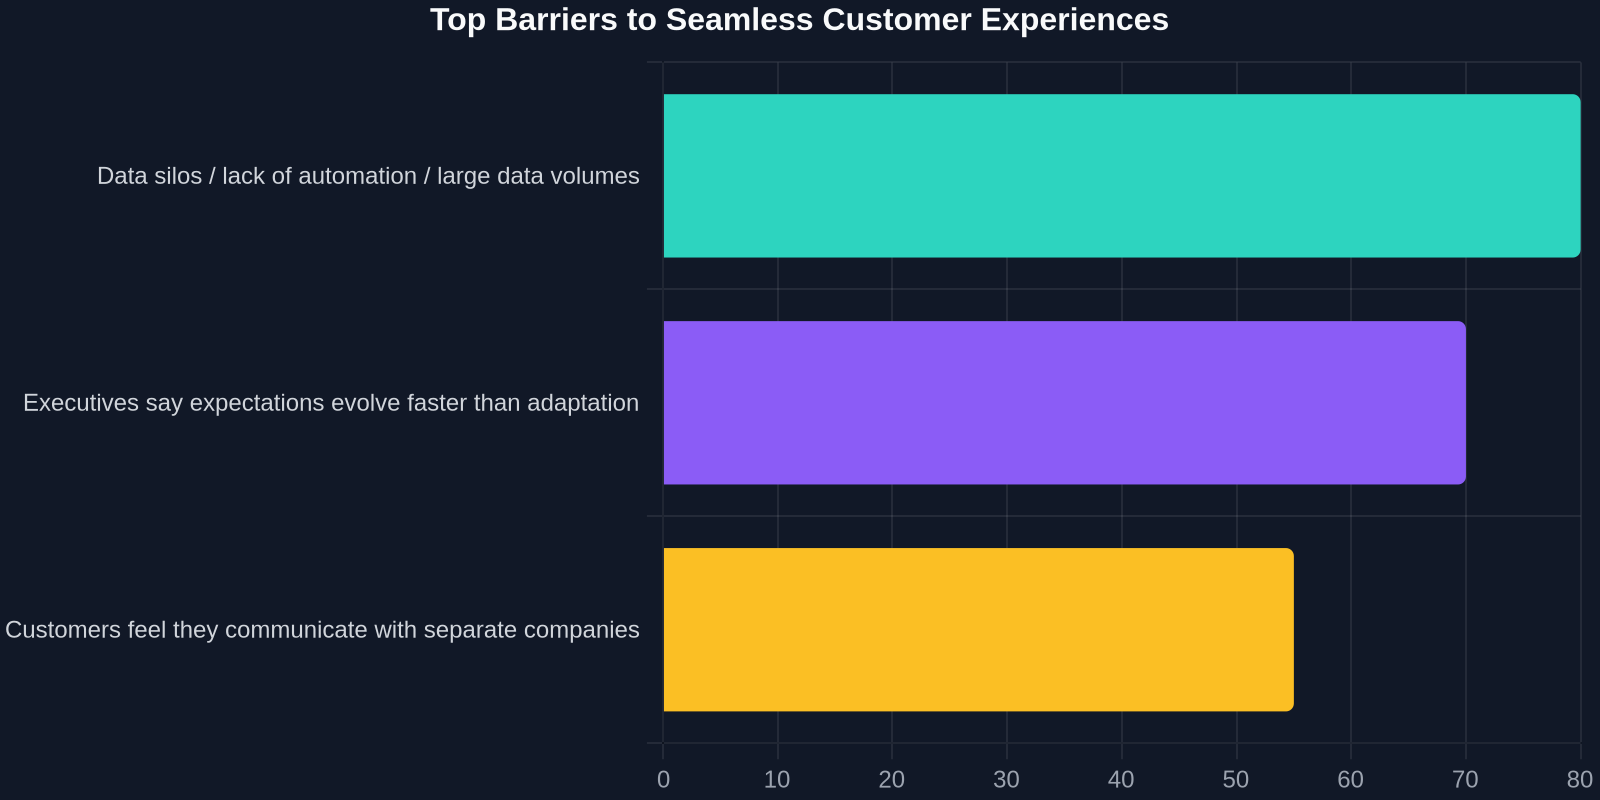
Проблема усугубляется, когда ожидания опережают адаптацию. Исследование PwC по клиентскому опыту за 2025 год показало, что70% руководителей говорят, что ожидания клиентов меняются быстрее, чем компания может адаптироваться. Если ваши данные заперты в ведомственных хранилищах, ваша способность адаптироваться уже подорвана. Вы не можете персонализировать, прогнозировать или проактивно решать проблемы, когда необходимые сигналы разбросаны по несвязанным системам.
Коренные причины разрозненных данных
Несколько структурных факторов создают и укрепляют разрозненность:
- Устаревшие инструменты, внедренные в разное время разными командами без дорожной карты интеграции.
- Ведомственное владение данными (поддержка владеет тикетами, продажи — CRM, продукт — данными об использовании) без общего слоя данных.
- Контроль безопасности и соответствия, ограничивающий межфункциональный доступ, даже когда существуют законные бизнес-потребности.
- Отсутствие единой модели данных клиента или идентификатора, связывающего взаимодействия по каналам и системам.
- Ручные процессы, зависящие от копирования и вставки контекста между инструментами, что приводит к ошибкам и задержкам.
Это не просто технические сбои; это симптомы организационных привычек. Хорошая новость: каждую из них можно решить с помощью правильных процессов и технологий, особенно AI-автоматизации поддержки, которая работает поверх вашего существующего стека и создает единый слой взаимодействия без необходимости полной замены систем.
Скрытая стоимость сброса контекста
Каждый раз, когда клиент меняет канал — от самообслуживания к чату, от чата к телефону, от телефона к электронной почте — происходит сброс контекста. Новый агент или бот начинает с нуля. Клиент повторяет свою историю. Команда заново вводит информацию, которая уже существует в другом месте. Эта избыточность не просто раздражает; она дорого обходится.
Рассмотрим тикет поддержки, который требует трех касаний для решения, потому что каждое взаимодействие теряет контекст. Стоимость тикета может удвоиться или утроиться по сравнению со сценарием единой обработки. Умножьте это на тысячи тикетов в месяц, и разрозненные данные становятся тихой утечкой прибыли. Согласно тому же отчету Customer Experience Dive, организации, которые не разрушают барьеры, с трудом создают необходимую основу для внедрения новых технологий, что означает, что они отстают от конкурентов, которые уже объединили свои данные о клиентах.
Финансовые последствия разрозненных данных о клиентах
Когда команды поддержки не имеют единого контекста, страдает каждый показатель, важный для бизнеса. Время первого ответа раздувается, потому что агенты должны собрать базовую информацию, прежде чем начать устранение неполадок. Время решения растягивается, так как агенты ищут по нескольким системам. CSAT падает, потому что клиенты повторяют себя. И, возможно, самое разрушительное: показатели отклонения тикетов остаются стабильно низкими, потому что слои самообслуживания и AI не могут получить доступ к полной истории клиента, необходимой для проактивного решения проблем.
Риск для выручки ошеломляет. Исследование Qualtrics XM Institute в ноябре 2025 года оценило, что плохой клиентский опыт поставит под угрозу примерно 2,94 триллиона долларов глобальной выручки. Хотя не все это вызвано только разрозненными данными, разрозненная информация является основным фактором непоследовательного, низкоконтекстного и раздражающего опыта, который ведет к оттоку клиентов.
Самый дорогой тикет поддержки — это тот, который ваша команда уже решила, но не может вспомнить, что решила. Разрозненные данные превращают каждый повторный контакт в совершенно новую проблему, умножая затраты и разочарование клиентов.
Для средней SaaS-компании с 50 агентами поддержки даже улучшение среднего времени решения на 15% может привести к шестизначной годовой экономии. Лучший контекст означает меньше эскалаций, меньше повторных контактов и больше тикетов, решенных с первого касания. И это еще без учета эффекта защиты выручки: удержание клиентов, которые в противном случае ушли бы из-за плохого обслуживания.
Что ожидают клиенты против того, что дают разрозненные данные
Клиентам не важно, какие у вас внутренние инструменты. Им важно одно: чтобы их узнавали как одного и того же человека в каждом взаимодействии. Если они написали в поддержку во вторник по поводу ошибки в выставлении счетов, они ожидают, что агент по телефону в среду будет об этом знать. Если они задали чат-боту вопрос о продукте, они ожидают, что человек-агент, который подхватит разговор, будет иметь этот контекст. Когда этого не происходит, доверие разрушается быстро.
Цифры красноречивы. **79% клиентов хотят стабильности во взаимодействиях между отделами, но 55% чувствуют, что общаются с разными компаниями.**Это означает, что более половины ваших клиентов считают, что ваша организация фундаментально фрагментирована. Разрыв между 79% и 55% — это прямая мера долга по клиентскому опыту, вызванного разрозненными системами.
| Metric | With Siloed Data | With Unified AI Support |
|---|---|---|
| First response time | 4–8 hours | Under 2 minutes |
| Ticket deflection rate | 10–15% | 40–60% |
| CSAT score | 72% | 92% |
| Average handle time | 12–15 minutes | 5–7 minutes |
Как автоматизация поддержки на основе ИИ разрушает информационные барьеры (не разрушая ваш стек)
Слишком многие руководители службы поддержки предполагают, что им нужен масштабный проект по созданию хранилища данных, прежде чем они смогут улучшить CX. Это предположение задерживает действия на 12–18 месяцев и сжигает бюджет. Более практичный путь — развернуть слой ИИ-поддержки, который подключается к вашим существующим инструментам через API, нормализует идентификацию клиента и создает граф контекста в реальном времени для каждого взаимодействия.
Successly, например, создан именно для этой цели. Он интегрируется с вашей службой поддержки, CRM, биллинговой системой и базой знаний, чтобы понимать, кто является клиентом, о чем он спрашивал ранее, что приобрел и какие проблемы открыты в данный момент. Вместо замены вашего стека он объединяет контекст и использует его для автоматизации ответов через чат, электронную почту и самообслуживание.
Четыре способа устранения информационных барьеров с помощью автоматизации поддержки на основе ИИ
1.Единая идентификация клиента и таймлайнИИ объединяет взаимодействия из электронной почты, чата, CRM и биллинга в единое хронологическое представление. Агенты и боты видят одну и ту же полную картину, устраняя «сброс контекста» при каждой передаче обращения.
2.Поиск знаний в реальном времени по всем источникамВместо того чтобы заставлять агентов искать в шести инструментах, ИИ ищет во всех подключенных системах одновременно и выдает нужный ответ, правило или процесс. Это напрямую решает проблему 80% команд, которые испытывают трудности из-за объема данных и отсутствия автоматизации.
3.Проактивное отсеивание тикетов с полным контекстомКогда клиент задает вопрос, на который уже был дан ответ ранее в его истории, ИИ может обработать его мгновенно. Показатель отсеивания вырастает с 10–15% до 40–60%, потому что ИИ не ограничен статичными часто задаваемыми вопросами, он может использовать фактическую ситуацию клиента, чтобы дать точный ответ.
4.Интеллектуальная эскалация с полными сводкамиКогда требуется вмешательство человека, ИИ передает структурированную сводку: что хотел клиент, что уже было испробовано, какова вероятная проблема и рекомендуемые следующие действия. Агенты экономят 3–5 минут на каждый тикет, а клиентам никогда не приходится повторяться.
Это не футуристическое видение. Это текущая операционная реальность для команд поддержки, которые рассматривают унификацию данных как предпосылку для внедрения ИИ, а не как запоздалую мысль. Ключевая идея: ИИ усиливает любые данные, к которым имеет доступ. Если он может получить доступ лишь к части пути клиента, он будет создавать фрагментированный и разочаровывающий опыт. Если он может получить доступ к полному контексту, он становится множителем эффективности вашей команды.
5 шагов к устранению информационных барьеров в поддержке клиентов
Вам не нужен 12-месячный проект трансформации данных, чтобы начать видеть результаты. Вам нужно целенаправленное и последовательное внедрение, которое обеспечивает быстрые победы, создавая основу для более масштабной унификации. Вот практическая система, которую используют руководители поддержки.
Шаг 1: Составьте карту пути клиента и выявите пробелы в данных
Прежде чем трогать какие-либо инструменты, нанесите на карту каждую точку контакта клиента с вашей компанией — от первого посещения сайта до онбординга, поддержки и продления подписки. Для каждой точки контакта перечислите, где хранятся данные и кто имеет к ним доступ. Отметьте любые моменты, когда клиенту приходится повторять информацию или агенту — переключаться между инструментами. Это и есть ваши самые значимые информационные барьеры.
Шаг 2: Выберите один сценарий с высоким объемом запросов и низким риском
Не пытайтесь унифицировать всё сразу. Выберите сценарий с большим количеством тикетов и относительно простыми путями решения: сброс пароля, проверка статуса заказа, типовые вопросы по биллингу или вопросы по онбордингу. Подключите две-три системы, необходимые для этого сценария. Измерьте показатели до и после. Уровень отсеивания в 30–40% по этому сценарию обеспечивает немедленный ROI и создает внутренний импульс.
Шаг 3: Разверните слой ИИ-поддержки, который нормализует идентичность
Ваш ИИ-инструмент должен уметь сопоставлять одного и того же клиента в записях электронной почты, чата и CRM. Это требует единого идентификатора клиента (обычно email или ID аккаунта) и возможности объединения истории взаимодействий. Без этого ваш ИИ будет страдать от тех же сбросов контекста, что и ваши агенты-люди. Successly выполняет эту нормализацию автоматически, но если вы строите систему внутри компании, заложите это как обязательное требование.
Шаг 4: Автоматизируйте доступ к знаниям и отсеивание тикетов
После унификации идентичности подключите к ИИ-слою базу знаний, документацию по продукту и руководства по устранению неполадок. Настройте ИИ на ответы на распространенные вопросы с полным контекстом, а не просто по совпадению ключевых слов. Затем измеряйте отсеивание, CSAT и сэкономленное время агентов. Улучшайте ответы на основе циклов обратной связи, в которых агенты могут исправлять или совершенствовать ответы ИИ.
Шаг 5: Переходите к более сложным сценариям и кросс-функциональному контексту
После подтверждения ценности на одном сценарии расширяйтесь на более сложные типы тикетов: изменение подписки, техническое устранение неполадок, предотвращение риска оттока. На этом этапе подключите данные об использовании продукта и историю платежей, чтобы ИИ мог проактивно выявлять проблемы до того, как клиенты свяжутся с вами. Именно здесь начинается реальная защита выручки.
Измерение ROI: как выглядит успех при унифицированных данных о клиентах
Разговоры о ROI с финансовым отделом требуют большего, чем «улучшение клиентского опыта». Вам нужны метрики, связанные со снижением затрат, удержанием выручки и производительностью. Вот что отслеживать, когда вы устраняете информационные барьеры с помощью автоматизации поддержки на основе ИИ.
Метрики экономии затрат
-**Время первого ответа (FRT):**С часов до минут. Более быстрое FRT сокращает повторные обращения и повышает CSAT. -**Среднее время обработки (AHT):**Более низкий AHT означает, что агенты решают больше тикетов за смену. Типичное снижение: 30–50%. -**Показатель отсеивания тикетов:**Процент тикетов, решенных без участия человека. Единый контекст может повысить его с 10–15% до 40–60%. -**Стоимость тикета:**Совокупный эффект от снижения AHT и повышения отсеивания обычно снижает стоимость тикета на 40–60%.
Метрики выручки и удержания
-**CSAT и NPS:**Более высокая стабильность повышает удовлетворенность. Компании, переходящие от разрозненной поддержки к единой, часто наблюдают рост CSAT с нижних 70-х до 90+. -**Коэффициент удержания клиентов:**Меньше разочаровывающих впечатлений — значит ниже отток. Даже улучшение удержания на 1–2% может стоить миллионы для SaaS-бизнеса. -**Доход от расширения:**Когда у поддержки есть полный контекст, агенты могут естественно выявлять возможности апселла и кросс-селла, не будучи навязчивыми.
Метрики операционной эффективности
-**Время адаптации агента:**Новые агенты быстрее выходят на полную производительность, когда ИИ предоставляет предлагаемые ответы и контекст, вместо того чтобы требовать запоминания шести инструментов. -**Показатель эскалаций:**Меньше эскалаций на вторую/третью линию, потому что первая линия имеет лучший контекст и помощь ИИ. -Удовлетворенность сотрудников: Агенты поддержки сообщают о более высокой удовлетворенности работой, когда им не приходится быть «человеческими интеграторами», копирующими данные между системами.
Нельзя автоматизировать то, что вы не видите. Единые данные — это необходимое условие для ИИ, а не запоздалая мысль. Компании, которые рассматривают интеграцию данных как первостепенную инвестицию, получают совокупный ROI по показателям отклонения, CSAT и удержания.
Распространенные ошибки при внедрении ИИ на основе разрозненных данных
Как и в случае с любой технологией, процент неудач высок, когда игнорируются фундаментальные проблемы. Вот наиболее распространенные ловушки и способы их избежать.
Ошибка 1: Автоматизация до объединения
Развертывание ИИ-чатботов, которые имеют доступ только к статическому FAQ, похоже на найм блестящего агента, которому завязывают глаза. ИИ будет давать общие ответы, раздражать клиентов и создавать больше работы для живых агентов. Всегда сначала объединяйте контекст, затем автоматизируйте.
Ошибка 2: Игнорирование передачи человеку
Даже лучший ИИ отклоняет только 40–60% тикетов. Оставшиеся тикеты требуют бесшовной передачи живым агентам с полным контекстом. Если ваш ИИ и хелпдеск не обмениваются данными, вы просто переместили разрозненность. Сначала спроектируйте путь эскалации.
Ошибка 3: Отношение к объединению данных как к разовому проекту
Источники данных развиваются. Добавляются новые инструменты, меняются API, и пути клиентов меняются. Единые данные требуют постоянного обслуживания. Назначьте ответственного за данные или используйте ИИ-платформу, которая автоматически синхронизирует и нормализует контекст в подключенных системах.
Ошибка 4: Измерение активности вместо результатов
Не празднуйте «количество диалогов с ИИ», если эти диалоги не решают тикеты и не улучшают CSAT. Измеряйте коэффициент отклонения, коэффициент решения, CSAT и время до решения. Это метрики, которые связаны с доходом.
Заключение: Разрушьте хранилища, затем масштабируйтесь с ИИ
Разрозненные данные — это не просто головная боль ИТ-отдела, это главный барьер, стоящий между вашими клиентами и бесшовным опытом, которого они требуют. Учитывая, что 79% клиентов ожидают согласованности, а 55% чувствуют, что общаются с разными компаниями, разрыв достаточно велик, чтобы вызвать отток клиентов и истощить доход. $2,94 триллиона, находящиеся под угрозой из-за плохого клиентского опыта, должны быть достаточным основанием, чтобы сделать объединение данных приоритетом на уровне совета директоров.
Путь вперед не требует массовой замены всего. Развернув автоматизацию поддержки на основе ИИ, которая работает поверх вашего существующего стека и объединяет контекст клиента в реальном времени, вы можете сократить время решения, повысить коэффициент отклонения и защитить доход. Successly создан именно для этого: он подключает ваши инструменты, нормализует идентификацию и автоматизирует поддержку с полным контекстом, чтобы ваша команда перестала быть человеческими интеграторами и начала быть драйверами успеха клиентов.
Разрушьте хранилища. Раскройте контекст. Наблюдайте, как ваш CSAT растет, а стоимость тикета падает.
Хотите увидеть, как Successly объединяет ваши данные поддержки и превращает их в мгновенную ценность для клиента?
Запишитесь на демо сегодня и получите бесплатный аудит хранилищ для вашего стека поддержки клиентов.