Données cloisonnées : la barrière cachée qui sabote des expériences client fluides (et comment y remédier)
Les attentes des clients n'ont jamais été aussi élevées. Ils veulent des réponses en quelques secondes, une cohérence entre le chat, l'e-mail et le téléphone, et aucun besoin de se répéter. Pourtant, en coulisses, la plupart des organisations de support fonctionnent avec des outils fragmentés et des sources de données déconnectées. Un client appelle après avoir envoyé un e-mail au support, et l'agent n'a aucune idée de ce qui a déjà été discuté. Un chatbot répond à une question sur les prix, mais l'agent humain qui prend le relais n'en voit aucun contexte. C'est la réalité quotidienne des données cloisonnées, et cela coûte silencieusement des millions aux entreprises B2B et SaaS en attrition, en inefficacité et en revenus manqués.
Selon un rapport Salesforce de 2025, 79 % des clients souhaitent une cohérence dans les interactions entre les départements, mais 55 % ont l'impression de communiquer avec des entreprises distinctes plutôt qu'avec une marque unifiée.Cet écart n'est pas un problème de perception, c'est un problème d'architecture de données. Et cela va devenir plus coûteux : le Qualtrics XM Institute estimait en novembre 2025 que les mauvaises expériences client mettraient environ$2.94 trillionde revenus mondiaux en jeu.
Pour les responsables du support, les fondateurs de SaaS et les responsables de la réussite client, la directive est claire : abattre les silos de données ou regarder vos indicateurs de rétention se dégrader. Ce guide explique pourquoi les données cloisonnées sont le principal obstacle à des expériences client fluides, quantifie l'impact commercial et présente un cadre pratique axé sur le ROI pour utiliser l'automatisation du support par IA afin d'unifier le contexte et d'étendre le support sans augmenter les effectifs.
Pourquoi les silos de données persistent dans le support client, et pourquoi ils sont dangereux
La plupart des piles de support ont grandi de manière organique. Un helpdesk ici, un CRM là, une base de connaissances dans un autre onglet, un système de facturation auquel seule la finance a accès, et un outil d'analyse produit qui vit avec l'ingénierie. Chaque système capture une partie du parcours client, mais aucun ne partage une image complète. Résultat : les agents naviguent entre cinq écrans, reconstituent le contexte manuellement et manquent encore des détails critiques.
L'analyse de Customer Experience Dive sur les données cloisonnées renforce une réalité brutale : abattre les silos peut aider les marques à développer une image plus complète de leurs clients et à former la base nécessaire au déploiement de nouvelles technologies. Pourtant, la plupart des entreprises n'en sont pas là. En fait,**80 % des répondants sont entravés par un manque d'automatisation, des données cloisonnées ou des volumes de données si importants que leurs équipes ne peuvent pas en extraire d'informations pertinentes.**Cette statistique devrait arrêter net tous les responsables du support : quatre organisations sur cinq sont paralysées sur le plan opérationnel par leur propre architecture de données.
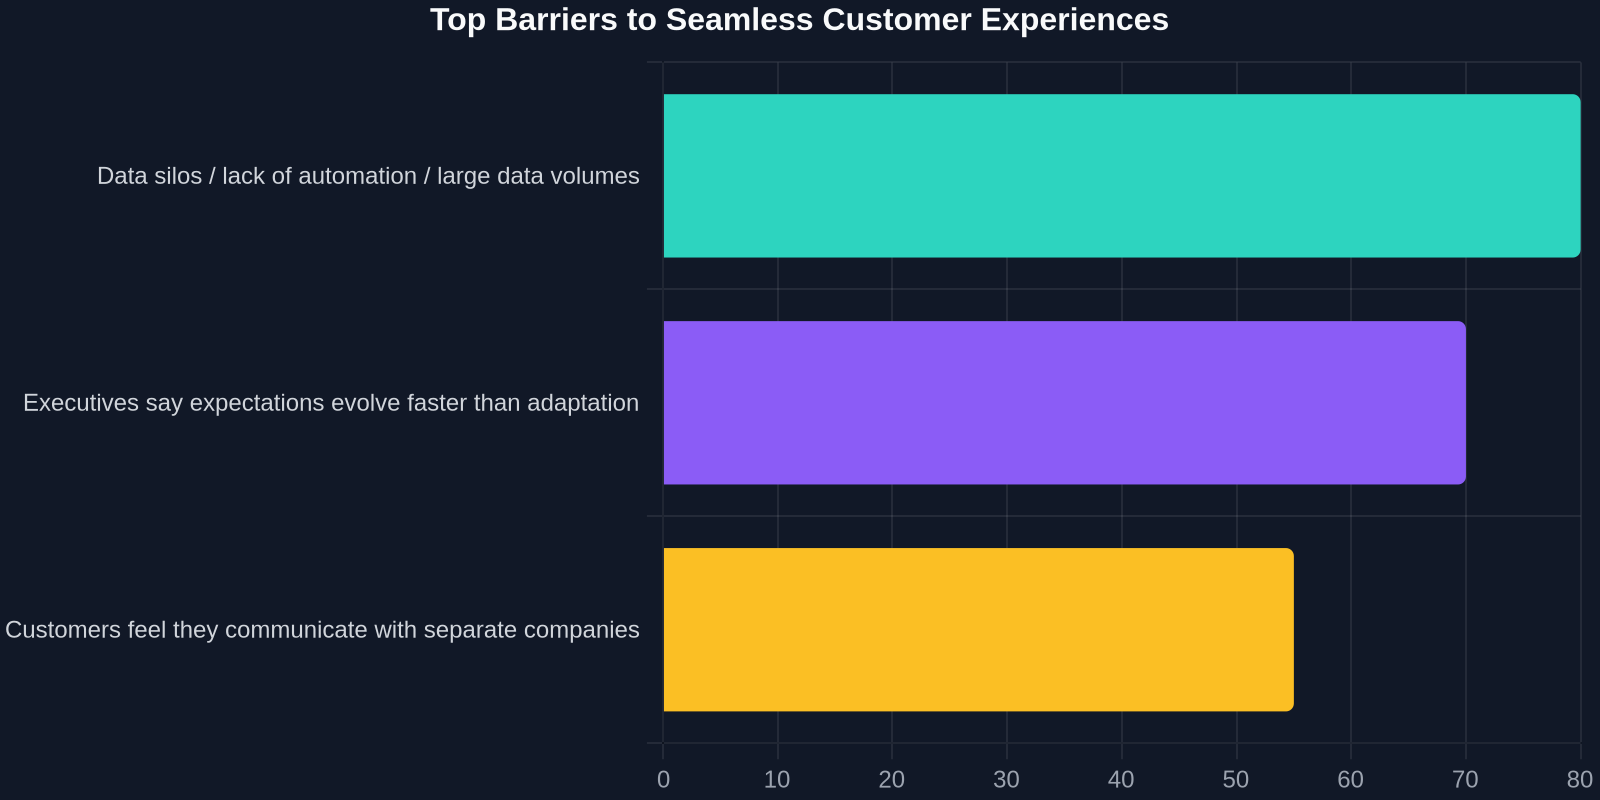
Le problème s'aggrave lorsque les attentes dépassent l'adaptation. L'enquête 2025 sur l'expérience client de PwC a révélé que70 % des dirigeants affirment que les attentes des clients évoluent plus vite que l'entreprise ne peut s'adapter. Si vos données sont enfermées dans des silos départementaux, votre capacité d'adaptation est déjà compromise. Vous ne pouvez pas personnaliser, prédire ou résoudre les problèmes de manière proactive lorsque les signaux nécessaires sont dispersés dans des systèmes déconnectés.
Les causes profondes des silos de données
Plusieurs facteurs structurels créent et renforcent les silos :
- Des outils hérités adoptés à différents moments par différentes équipes sans feuille de route d'intégration.
- La propriété départementale des données (le support possède les tickets, la vente possède le CRM, le produit possède les données d'utilisation) sans couche de données partagée.
- Des contrôles de sécurité et de conformité qui restreignent l'accès interfonctionnel, même lorsque des besoins commerciaux légitimes existent.
- L'absence d'un modèle de données client unifié ou d'un identifiant qui relie les interactions entre les canaux et les systèmes.
- Des flux de travail manuels qui dépendent du copier-coller du contexte entre les outils, ce qui introduit des erreurs et des retards.
Ce ne sont pas seulement des problèmes techniques ; ce sont des symptômes d'habitudes organisationnelles. La bonne nouvelle : chacun peut être traité avec les bons processus et la bonne technologie, en particulier l'automatisation du support par IA qui se superpose à votre pile existante et crée une couche d'interaction unifiée sans nécessiter une refonte complète.
Le coût caché des réinitialisations de contexte
Chaque fois qu'un client change de canal, du libre-service au chat, du chat au téléphone, du téléphone à l'e-mail, une réinitialisation du contexte se produit. Le nouvel agent ou bot repart de zéro. Le client répète son histoire. L'équipe ressaisit des informations qui existent déjà ailleurs. Cette redondance n'est pas seulement frustrante ; elle est coûteuse.
Considérez un ticket de support qui nécessite trois interventions pour être résolu parce que chaque transfert perd du contexte. Le coût par ticket peut doubler ou tripler par rapport à un scénario de traitement unifié. Multipliez cela par des milliers de tickets par mois, et les données cloisonnées deviennent une fuite de profit silencieuse. Selon le même rapport de Customer Experience Dive, les organisations qui ne parviennent pas à abattre les silos peinent à former la base nécessaire au déploiement de nouvelles technologies, ce qui signifie qu'elles prennent encore plus de retard sur les concurrents qui ont déjà unifié leurs données clients.
Le coût financier des données client cloisonnées
Lorsque les équipes de support manquent de contexte unifié, chaque indicateur qui compte pour l'entreprise en souffre. Les délais de première réponse explosent car les agents doivent rassembler les informations de base avant même de pouvoir commencer le dépannage. Les délais de résolution s'allongent tandis que les agents recherchent dans plusieurs systèmes. Le CSAT chute parce que les clients se répètent. Et peut-être le plus dommageable : les taux de déviation des tickets restent obstinément bas car les couches de libre-service et d'IA ne peuvent pas accéder à l'historique client complet nécessaire pour résoudre les problèmes de manière proactive.
Le risque en termes de revenus est stupéfiant. Les recherches du Qualtrics XM Institute de novembre 2025 estimaient que les mauvaises expériences client mettraient environ $2.94 trillionde revenus mondiaux en jeu. Bien que tout cela ne soit pas uniquement causé par les silos de données, les informations cloisonnées contribuent largement à des expériences incohérentes, pauvres en contexte et frustrantes qui alimentent l'attrition.
Le ticket de support le plus coûteux est celui que votre équipe a déjà résolu, mais dont elle ne se souvient pas l'avoir résolu. Les données cloisonnées transforment chaque contact répété en un tout nouveau problème, multipliant les coûts et la frustration des clients.
Pour une entreprise SaaS de taille moyenne avec 50 agents de support, même une amélioration de 15 % du temps moyen de résolution peut se traduire par des économies annuelles à six chiffres. Un meilleur contexte signifie moins d'escalades, moins de contacts répétés et plus de tickets résolus au premier contact. Cela sans compter l'effet de protection des revenus : fidéliser les clients qui autrement partiraient en raison d'un mauvais service.
Ce que les clients attendent vs ce que les silos offrent
Les clients se moquent de vos outils internes. Ils ne se soucient que d'une chose : être reconnus comme la même personne à chaque interaction. S'ils ont envoyé un e-mail au support mardi au sujet d'une erreur de facturation, ils s'attendent à ce que l'agent téléphonique de mercredi soit au courant. S'ils ont posé une question produit à un chatbot, ils s'attendent à ce que l'agent humain qui prend le relais ait ce contexte. Lorsque cela ne se produit pas, la confiance s'érode rapidement.
Les chiffres sont éloquents.**79 % des clients souhaitent une cohérence dans les interactions entre les départements, mais 55 % ont l'impression de communiquer avec des entreprises distinctes.**Cela signifie que plus de la moitié de vos clients pensent que votre organisation est fondamentalement fragmentée. L'écart entre 79 % et 55 % est une mesure directe de la dette d'expérience causée par les systèmes cloisonnés.
| Metric | With Siloed Data | With Unified AI Support |
|---|---|---|
| First response time | 4–8 hours | Under 2 minutes |
| Ticket deflection rate | 10–15% | 40–60% |
| CSAT score | 72% | 92% |
| Average handle time | 12–15 minutes | 5–7 minutes |
Comment l'automatisation du support par IA brise les silos (sans casser votre pile technologique)
Trop de responsables du support supposent qu'ils ont besoin d'un projet massif d'entrepôt de données avant de pouvoir améliorer l'expérience client. Cette hypothèse retarde l'action de 12 à 18 mois et épuise le budget. La voie la plus pratique consiste à déployer une couche de support IA qui se connecte à vos outils existants via des API, normalise l'identité client et crée un graphe de contexte en temps réel pour chaque interaction.
Successly, par exemple, est conçu exactement dans ce but. Il s'intègre à votre helpdesk, votre CRM, votre système de facturation et votre base de connaissances pour comprendre qui est le client, ce qu'il a déjà demandé, ce qu'il a acheté et quels problèmes sont actuellement ouverts. Au lieu de remplacer votre pile technologique, il unifie le contexte et utilise ce contexte pour automatiser les réponses via le chat, l'e-mail et le libre-service.
Quatre façons dont l'automatisation du support par IA élimine les silos
1.Identité client unifiée et chronologieL'IA assemble les interactions provenant de l'e-mail, du chat, du CRM et de la facturation en une vue chronologique unique. Les agents et les bots voient la même image complète, éliminant ainsi la « réinitialisation du contexte » à chaque transfert.
2.Récupération des connaissances en temps réel sur toutes les sourcesAu lieu de forcer les agents à chercher dans six outils, l'IA recherche simultanément dans tous les systèmes connectés et fait apparaître la réponse, la politique ou le processus exact requis. Cela répond directement aux 80 % d'équipes entravées par le volume de données et le manque d'automatisation.
3.Détournement proactif des tickets avec contexte completLorsqu'un client pose une question qui a déjà été traitée ailleurs dans son historique, l'IA peut la gérer instantanément. Les taux de détournement passent de 10 à 15 % à 40 à 60 %, car l'IA ne se limite pas à des FAQ statiques : elle peut utiliser la situation réelle du client pour fournir une réponse précise.
4.Escalade intelligente avec résumés completsLorsqu'une intervention humaine est requise, l'IA transmet un résumé structuré : ce que le client voulait, ce qui a déjà été essayé, la cause probable du problème et les prochaines actions recommandées. Les agents économisent 3 à 5 minutes par ticket, et les clients n'ont jamais à se répéter.
Ce n'est pas une vision futuriste. C'est la réalité opérationnelle actuelle pour les équipes de support qui considèrent l'unification des données comme un prérequis au déploiement de l'IA, et non comme une réflexion après coup. L'idée clé : l'IA amplifie toutes les données auxquelles elle peut accéder. Si elle n'accède qu'à une fraction du parcours client, elle produira des expériences fragmentées et frustrantes. Si elle accède au contexte complet, elle devient un multiplicateur de force pour votre équipe.
Un cadre en 5 étapes pour éliminer les silos de données dans le support client
Vous n'avez pas besoin d'un projet de transformation des données de 12 mois pour commencer à voir des résultats. Vous avez besoin d'un déploiement ciblé et séquencé qui génère des victoires rapides tout en posant les bases d'une unification plus large. Voici un cadre pratique utilisé par les responsables du support.
Étape 1 : Cartographier le parcours client et identifier les lacunes de données
Avant de toucher à un outil, cartographiez chaque point de contact qu'un client a avec votre entreprise, de la première visite sur le site Web à l'intégration, au support, puis au renouvellement. Pour chaque point de contact, indiquez où vivent les données et qui peut y accéder. Marquez tout point où un client doit répéter des informations ou où un agent doit changer d'outil. Ce sont vos silos à plus fort impact.
Étape 2 : Choisir un cas d'utilisation à volume élevé et à faible risque
N'essayez pas de tout unifier d'un coup. Choisissez un cas d'utilisation avec un volume de tickets élevé et des chemins de résolution relativement simples, comme les réinitialisations de mot de passe, les vérifications de statut de commande, les FAQ de facturation ou les questions d'intégration. Connectez les deux ou trois systèmes nécessaires à ce cas d'utilisation. Mesurez l'avant et l'après. Un taux de détournement de 30 à 40 % sur ce cas d'utilisation crée un ROI immédiat et renforce la dynamique interne.
Étape 3 : Déployer une couche de support IA qui normalise l'identité
Votre outil d'IA doit être capable de faire correspondre le même client à travers les enregistrements d'e-mail, de chat et de CRM. Cela nécessite un identifiant client unifié (généralement l'e-mail ou l'identifiant de compte) et la capacité de fusionner l'historique des interactions. Sans cela, votre IA subira les mêmes réinitialisations de contexte que vos agents humains. Successly gère cette normalisation automatiquement, mais si vous construisez en interne, prévoyez un budget pour cette exigence non négociable.
Étape 4 : Automatiser l'accès aux connaissances et le détournement des tickets
Une fois l'identité unifiée, connectez votre base de connaissances, votre documentation produit et vos guides de dépannage à la couche d'IA. Configurez l'IA pour répondre aux questions courantes avec un contexte complet, et non pas simplement par correspondance de mots-clés. Mesurez ensuite le détournement, le CSAT et le temps d'agent économisé. Itérez sur les réponses grâce à des boucles de rétroaction où les agents peuvent corriger ou améliorer les réponses de l'IA.
Étape 5 : Étendre à des flux de travail plus complexes et à un contexte interfonctionnel
Après avoir prouvé la valeur sur un cas d'utilisation, étendez-vous à des types de tickets plus complexes, aux changements d'abonnement, au dépannage technique et aux interventions liées au risque d'attrition. À ce stade, intégrez les données d'utilisation du produit et l'historique de facturation afin que l'IA puisse identifier de manière proactive les problèmes avant que les clients ne vous contactent. C'est là que commence la véritable protection des revenus.
Mesurer le ROI : à quoi ressemble le succès avec des données client unifiées
Les discussions sur le ROI avec les finances exigent plus qu'une « meilleure expérience client ». Vous avez besoin de mesures liées à la réduction des coûts, à la rétention des revenus et à la productivité. Voici ce qu'il faut suivre lorsque vous éliminez les silos de données grâce à l'automatisation du support par IA.
Mesures d'économies de coûts
-**Délai de première réponse (FRT) :**De quelques heures à quelques minutes. Un FRT plus rapide réduit les contacts de suivi et améliore le CSAT. -**Temps moyen de traitement (AHT) :**Un AHT plus faible signifie que les agents résolvent plus de tickets par quart de travail. Réduction typique : 30 à 50 %. -**Taux de détournement des tickets :**Le pourcentage de tickets résolus sans intervention humaine. Un contexte unifié peut faire passer ce taux de 10 à 15 % à 40 à 60 %. -**Coût par ticket :**L'effet combiné d'un AHT plus faible et d'un détournement plus élevé réduit généralement le coût par ticket de 40 à 60 %.
Mesures de revenus et de rétention
-**CSAT et NPS :**Une plus grande cohérence stimule la satisfaction. Les entreprises qui passent d'un support cloisonné à un support unifié voient souvent leur CSAT passer d'environ 70 à plus de 90. -**Taux de rétention client :**Moins d'expériences frustrantes signifie une plus faible attrition. Même une amélioration de 1 à 2 % de la rétention peut valoir des millions pour une entreprise SaaS. -**Revenu d'expansion :**Lorsque le support dispose d'un contexte complet, les agents peuvent identifier naturellement les opportunités de vente incitative et de vente croisée, sans être insistants.
Mesures d'efficacité opérationnelle
-**Temps d'intégration des agents :**Les nouveaux agents montent en compétence plus rapidement lorsque l'IA fournit des réponses suggérées et du contexte, plutôt que d'exiger la mémorisation de six outils. -**Taux d'escalade :**Moins d'escalades vers les niveaux 2 et 3, car le niveau 1 dispose d'un meilleur contexte et d'une assistance IA. -Satisfaction des employés : Les agents du support déclarent une plus grande satisfaction au travail lorsqu'ils ne sont pas obligés d'être des intégrateurs humains copiant des données entre les systèmes.
Vous ne pouvez pas automatiser ce que vous ne pouvez pas voir. Les données unifiées sont la condition préalable à l'IA, pas une réflexion après coup. Les entreprises qui considèrent l'intégration des données comme un investissement de premier ordre débloquent un ROI composé en termes de déviation, de CSAT et de fidélisation.
Pièges courants lors du déploiement de l'IA sur des données cloisonnées
Comme pour toute technologie, le taux d'échec est élevé lorsque les problèmes fondamentaux sont ignorés. Voici les pièges les plus courants et comment les éviter.
Piège 1 : Automatiser avant d'unifier
Déployer des chatbots IA qui n'ont accès qu'à une FAQ statique, c'est comme embaucher un agent brillant et lui bander les yeux. L'IA donnera des réponses génériques, frustrera les clients et créera plus de travail pour les agents humains. Unifiez toujours d'abord le contexte, puis automatisez.
Piège 2 : Ignorer le transfert humain
Même la meilleure IA ne dévie que 40 à 60 % des tickets. Les tickets restants nécessitent un transfert transparent aux agents humains avec tout le contexte. Si votre IA et votre helpdesk ne partagent pas les données, vous avez simplement déplacé le silo. Concevez d'abord le chemin d'escalade.
Piège 3 : Considérer l'unification des données comme un projet ponctuel
Les sources de données évoluent. De nouveaux outils sont ajoutés, les API changent et les parcours clients se transforment. Les données unifiées nécessitent une maintenance continue. Nommez un gestionnaire de données ou utilisez une plateforme IA qui synchronise et normalise automatiquement le contexte sur l'ensemble des systèmes connectés.
Piège 4 : Mesurer l'activité plutôt que les résultats
Ne célébrez pas le « nombre de conversations IA » si ces conversations ne résolvent pas les tickets ou n'améliorent pas le CSAT. Mesurez le taux de déviation, le taux de résolution, le CSAT et le temps de résolution. Ce sont les métriques qui sont liées aux revenus.
Conclusion : Brisez les silos, puis passez à l'échelle avec l'IA
Les données cloisonnées ne sont pas seulement un casse-tête informatique, c'est le principal obstacle entre vos clients et les expériences transparentes qu'ils exigent. Avec 79 % des clients qui attendent de la cohérence et 55 % qui ont l'impression de parler à des entreprises distinctes, l'écart est suffisamment large pour provoquer du churn et drainer les revenus. Les 2,94 billions de dollars en jeu à cause de mauvaises expériences client devraient suffire à faire de l'unification des données une priorité au niveau du conseil d'administration.
La voie à suivre ne nécessite pas un remplacement massif. En déployant une automatisation du support IA qui se superpose à votre stack existant et unifie le contexte client en temps réel, vous pouvez réduire les temps de résolution, augmenter les taux de déviation et protéger les revenus. Successly est conçu pour cela : il connecte vos outils, normalise l'identité et automatise le support avec tout le contexte, afin que votre équipe cesse d'être des intégrateurs humains et devienne des moteurs de réussite client.
Brisez les silos. Débloquez le contexte. Regardez votre CSAT grimper et votre coût par ticket baisser.
Vous voulez voir comment Successly unifie vos données de support et les transforme en valeur client instantanée ?
Réservez une démo dès aujourd'hui et obtenez un audit gratuit des silos pour votre stack de support client.