Silo's in gegevens: De verborgen barrière die naadloze klantervaringen saboteert (en hoe je het oplost)
Klantverwachtingen zijn nog nooit zo hoog geweest. Ze willen antwoorden in seconden, consistentie via chat, e-mail en telefoon, en nul noodzaak om zichzelf te herhalen. Maar achter de schermen werken de meeste ondersteuningsorganisaties met gefragmenteerde tools en niet-verbonden gegevensbronnen. Een klant belt na een e-mail naar de ondersteuning, en de agent heeft geen idee wat er al is besproken. Een chatbot beantwoordt een prijsvraag, maar de menselijke agent die overneemt, ziet geen van die context. Dit is de dagelijkse realiteit van gesilo's gegevens, en het kost B2B- en SaaS-bedrijven stilletjes miljoenen aan churn, inefficiëntie en gemiste inkomsten.
Volgens een Salesforce-rapport uit 2025 verlangt 79% van de klanten consistentie in interacties tussen afdelingen, maar heeft 55% het gevoel dat ze met aparte bedrijven communiceren in plaats van met één uniform merk.Die kloof is geen perceptieprobleem; het is een gegevensarchitectuurprobleem. En het wordt duurder: Qualtrics XM Institute schatte in november 2025 dat slechte klantervaringen ongeveer2,94 biljoen dollar aan wereldwijde inkomsten in gevaar zouden brengen.
Voor ondersteuningsleiders, SaaS-oprichters en customer success-managers is de opdracht duidelijk: breek gegevenssilo's af of zie hoe je retentiecijfers eroderen. Deze gids legt uit waarom gesilo's gegevens de belangrijkste barrière zijn voor naadloze klantervaringen, kwantificeert de zakelijke impact en biedt een praktisch, ROI-gericht raamwerk voor het gebruik van AI-ondersteuningsautomatisering om context te verenigen en ondersteuning te schalen zonder het team te vergroten.
Waarom gegevenssilo's blijven bestaan in klantondersteuning, en waarom ze gevaarlijk zijn
De meeste ondersteuningsstacks zijn organisch gegroeid. Een helpdesk hier, een CRM daar, een kennisbank in een ander tabblad, een facturatiesysteem dat alleen financiën kan openen, en een productanalysetool die bij de technische afdeling leeft. Elk systeem legt een deel van de klantreis vast, maar geen deelt een compleet beeld. Het resultaat: agents schakelen tussen vijf schermen, puzzelen context handmatig in elkaar en missen nog steeds cruciale details.
De analyse van Customer Experience Dive over gesilo's gegevens bevestigt een harde realiteit: het afbreken van silo's kan merken helpen een vollediger beeld van hun klanten te krijgen en de nodige basis vormen voor nieuwe tech-implementaties. Toch zijn de meeste bedrijven er niet. Sterker nog, **80% van de respondenten wordt gehinderd door een gebrek aan automatisering, gegevens die in silo's zitten, of zulke grote hoeveelheden gegevens dat hun teams geen zinvolle inzichten kunnen halen.**Deze statistiek zou elke ondersteuningsleider op zijn schreden moeten doen terugkeren: vier van de vijf organisaties zijn operationeel verlamd door hun eigen gegevensarchitectuur.
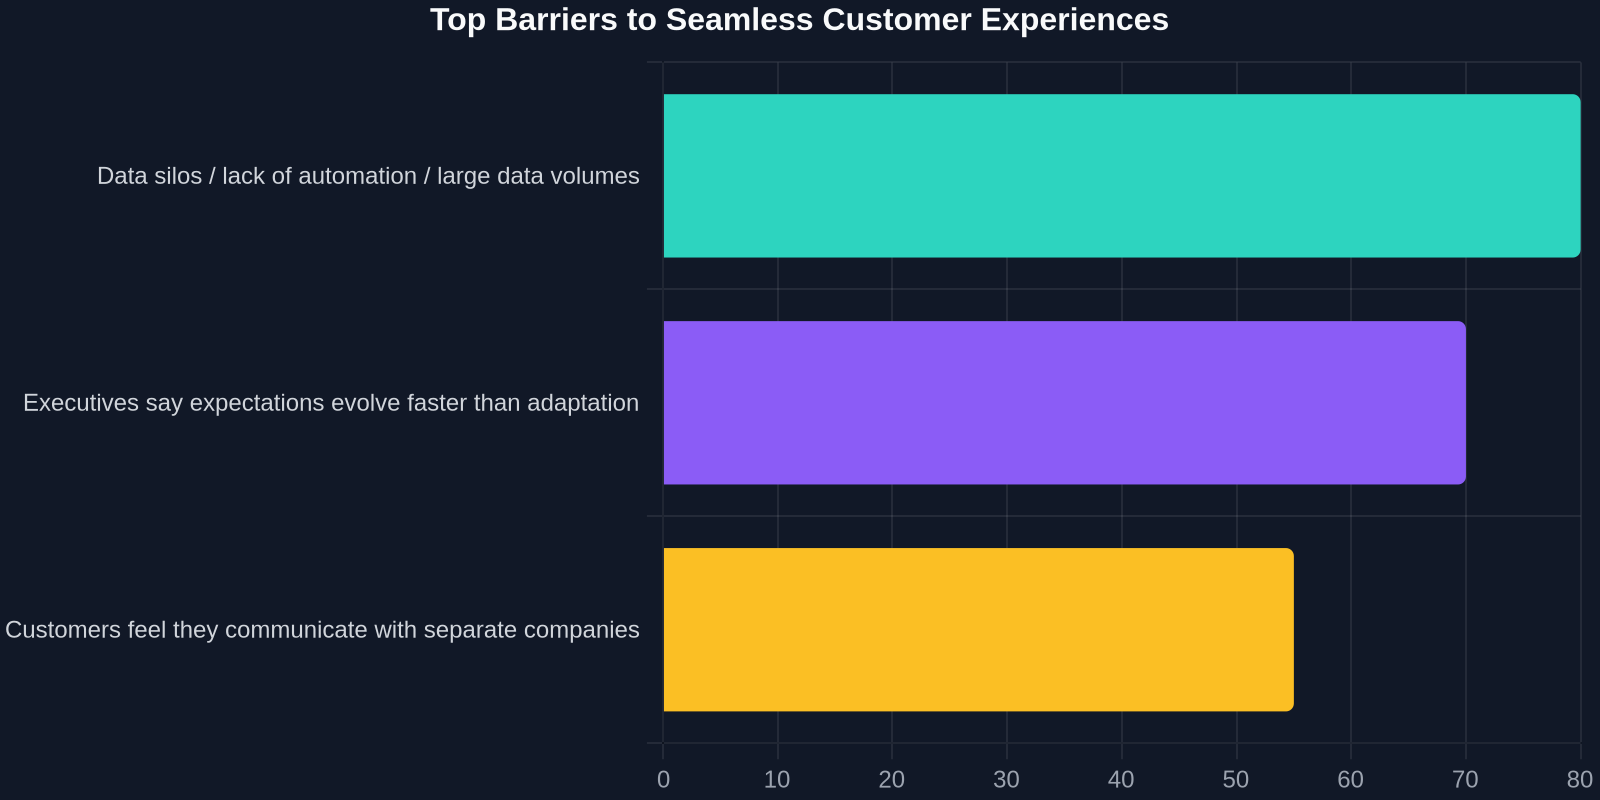
Het probleem wordt groter wanneer verwachtingen sneller evolueren dan aanpassing. PwC's Customer Experience Survey uit 2025 ontdekte dat70% van de leidinggevenden zegt dat klantverwachtingen sneller evolueren dan het bedrijf zich kan aanpassen. Als je gegevens vastzitten in afdelingssilo's, is je vermogen om je aan te passen al gecompromitteerd. Je kunt niet personaliseren, voorspellen of problemen proactief oplossen wanneer de benodigde signalen verspreid zijn over niet-verbonden systemen.
De hoofdoorzaken van gegevenssilo's
Verschillende structurele factoren creëren en versterken silo's:
- Legacy-tools die op verschillende tijdstippen zijn aangenomen door verschillende teams zonder integratie-roadmap.
- Afdelingsgericht eigendom van gegevens (ondersteuning bezit tickets, verkoop bezit CRM, product bezit gebruiksgegevens) zonder een gedeelde gegevenslaag.
- Beveiligings- en compliance-controles die cross-functionele toegang beperken, zelfs wanneer legitieme zakelijke behoeften bestaan.
- Gebrek aan een uniform klantgegevensmodel of identificatie die interacties over kanalen en systemen koppelt.
- Handmatige workflows die afhankelijk zijn van het kopiëren en plakken van context tussen tools, wat fouten en vertragingen introduceert.
Dit zijn niet alleen technische fouten; het zijn symptomen van organisatorische gewoontes. Het goede nieuws: elk kan worden aangepakt met de juiste processen en technologie, vooral AI-ondersteuningsautomatisering die bovenop je bestaande stack werkt en een uniforme interactielaag creëert zonder een volledige vervangingsingreep.
De verborgen kosten van context-resets
Elke keer dat een klant van kanaal wisselt, van selfservice naar chat, van chat naar telefoon, van telefoon naar e-mail, treedt een context-reset op. De nieuwe agent of bot begint opnieuw. De klant herhaalt zijn verhaal. Het team voert opnieuw informatie in die elders al bestaat. Deze redundantie is niet alleen frustrerend; het is duur.
Overweeg een ondersteuningsticket dat drie contactmomenten nodig heeft om op te lossen omdat elke overdracht context verliest. De kosten per ticket kunnen verdubbelen of verdrievoudigen in vergelijking met een uniforme afhandeling. Vermenigvuldig dat met duizenden tickets per maand, en gesilo's gegevens worden een stille winstlekkage. Volgens hetzelfde Customer Experience Dive-rapport worstelen organisaties die silo's niet afbreken om de nodige basis te vormen voor nieuwe tech-implementaties, wat betekent dat ze verder achterop raken bij concurrenten die hun klantgegevens al hebben verenigd.
De financiële impact van gesilo's klantgegevens
Wanneer ondersteuningsteams gebrek aan uniforme context hebben, lijdt elke voor het bedrijf belangrijke metriek. De eerste responstijden stijgen omdat agents basisinformatie moeten verzamelen voordat ze kunnen beginnen met probleemoplossing. Oplossingstijden rekken uit terwijl agents meerdere systemen doorzoeken. CSAT daalt omdat klanten zich herhalen. En misschien het schadelijkst: ticketafleidingspercentages blijven hardnekkig laag omdat de selfservice- en AI-lagen geen toegang hebben tot de volledige klantgeschiedenis die nodig is om problemen proactief op te lossen.
Het omzetrisico is verbluffend. Onderzoek van Qualtrics XM Institute in november 2025 schatte dat slechte klantervaringen ongeveer 2,94 biljoen dollar aan wereldwijde inkomsten in gevaar zouden brengen. Hoewel niet alles wordt veroorzaakt door gegevenssilo's alleen, is gesilo's informatie een primaire oorzaak van inconsistente, contextarme en frustrerende ervaringen die churn aanjagen.
Het duurste ondersteuningsticket is het ticket dat je team al heeft opgelost, maar zich niet herinnert te hebben opgelost. Gesilo's gegevens veranderen elk herhaald contact in een gloednieuw probleem, waardoor kosten en klantfrustratie worden vermenigvuldigd.
Voor een middelgroot SaaS-bedrijf met 50 ondersteuningsagenten kan zelfs een verbetering van 15% in de gemiddelde oplossingstijd leiden tot jaarlijkse besparingen van zes cijfers. Betere context betekent minder escalaties, minder herhaalde contactmomenten en meer tickets die bij het eerste contact worden opgelost. Dat is nog zonder rekening te houden met het inkomstenbeschermingseffect: klanten behouden die anders zouden churnen door slechte service.
Wat klanten verwachten vs. wat silo's leveren
Klanten geven niets om je interne tools. Ze geven om één ding: worden herkend als dezelfde persoon bij elke interactie. Als ze dinsdag een e-mail hebben gestuurd over een factureringsfout, verwachten ze dat de telefoonagent op woensdag daarvan op de hoogte is. Als ze een chatbot een productvraag hebben gesteld, verwachten ze dat de menselijke agent die overneemt die context heeft. Wanneer dat niet gebeurt, erodeert het vertrouwen snel.
De cijfers zijn hard. **79% van de klanten verlangt consistentie in interacties tussen afdelingen, maar 55% heeft het gevoel dat ze met aparte bedrijven communiceren.**Dat betekent dat meer dan de helft van je klanten vindt dat je organisatie fundamenteel gefragmenteerd is. De kloof tussen 79% en 55% is een directe maatstaf voor de ervaringsschuld die wordt veroorzaakt door gesilo's systemen.
| Metric | With Siloed Data | With Unified AI Support |
|---|---|---|
| First response time | 4–8 hours | Under 2 minutes |
| Ticket deflection rate | 10–15% | 40–60% |
| CSAT score | 72% | 92% |
| Average handle time | 12–15 minutes | 5–7 minutes |
Hoe AI-supportautomatisering silo's doorbreekt (zonder je stack te breken)
Te veel supportleiders gaan ervan uit dat ze een enorm datawarehouse-project nodig hebben voordat ze de klantervaring kunnen verbeteren. Die aanname vertraagt actie met 12–18 maanden en verbrandt budget. Het praktischere pad is het inzetten van een AI-supportlaag die via API's verbinding maakt met je bestaande tools, de klantidentiteit normaliseert en een realtime contextgrafiek creëert voor elke interactie.
Successly is bijvoorbeeld precies voor dit doel gebouwd. Het integreert met je helpdesk, CRM, factureringssysteem en kennisbank om te begrijpen wie de klant is, wat ze eerder hebben gevraagd, wat ze hebben gekocht en welke problemen momenteel openstaan. In plaats van je stack te vervangen, verenigt het de context en gebruikt die context om antwoorden te automatiseren via chat, e-mail en selfservice.
Vier manieren waarop AI-supportautomatisering silo's elimineert
1.Uniforme klantidentiteit en tijdlijnDe AI verbindt interacties uit e-mail, chat, CRM en facturering tot één chronologisch overzicht. Medewerkers en bots zien hetzelfde complete beeld, waardoor de 'contextreset' bij elke overdracht verdwijnt.
2.Realtime kennisophaling uit alle bronnenIn plaats van medewerkers te dwingen om zes tools te doorzoeken, doorzoekt de AI alle verbonden systemen tegelijkertijd en toont het exacte antwoord, beleid of proces dat nodig is. Dit pakt direct de 80% van de teams aan die worden belemmerd door datavolume en gebrek aan automatisering.
3.Proactieve ticketdeflectie met volledige contextWanneer een klant een vraag stelt die elders in hun geschiedenis al is beantwoord, kan de AI deze direct afhandelen. Deflectiepercentages gaan van 10–15% naar 40–60% omdat de AI niet beperkt is tot statische FAQ's, maar de werkelijke situatie van de klant kan gebruiken om een nauwkeurig antwoord te geven.
4.Intelligente escalatie met volledige samenvattingenWanneer menselijke interventie nodig is, overhandigt de AI een gestructureerde samenvatting: wat de klant wilde, wat er al was geprobeerd, wat het waarschijnlijke probleem is en aanbevolen vervolgacties. Medewerkers besparen 3–5 minuten per ticket en klanten hoeven zich nooit te herhalen.
Dit is geen futuristische visie. Het is de huidige operationele realiteit voor supportteams die data-unificatie behandelen als een voorwaarde voor AI-uitrol, niet als een bijzaak. Het belangrijkste inzicht: AI versterkt alles wat het kan bereiken qua data. Als het slechts toegang heeft tot een fractie van de klantreis, produceert het gefragmenteerde, frustrerende ervaringen. Als het toegang heeft tot de volledige context, wordt het een krachtvermenigvuldiger voor je team.
Een 5-stappenkader om datasilo's in klantondersteuning te doorbreken
Je hebt geen datatransformatieproject van 12 maanden nodig om resultaten te zien. Je hebt een gerichte, gefaseerde uitrol nodig die snelle successen oplevert terwijl het de basis legt voor grotere unificatie. Hier is een praktisch kader dat door supportleiders wordt gebruikt.
Stap 1: Breng de klantreis in kaart en identificeer datakloven
Voordat je een tool aanraakt, breng je elk contactpunt in kaart dat een klant met je bedrijf heeft, van het eerste websitebezoek tot onboarding, support en verlenging. Noteer voor elk contactpunt waar de data leeft en wie er toegang toe heeft. Markeer elk punt waar een klant informatie moet herhalen of waar een medewerker van tool moet wisselen. Dat zijn je silo's met de hoogste impact.
Stap 2: Kies één gebruiksscenario met hoog volume en laag risico
Probeer niet alles tegelijk te unificeren. Kies een gebruiksscenario met een hoog ticketvolume en relatief eenvoudige oplossingspaden: wachtwoordresets, bestelstatuscontroles, facturerings-FAQ's of onboardingvragen. Verbind de twee of drie systemen die nodig zijn voor dat gebruiksscenario. Meet de voor- en nasituatie. Een deflectiepercentage van 30–40% op dat gebruiksscenario levert onmiddellijke ROI op en bouwt intern momentum op.
Stap 3: Zet een AI-supportlaag in die identiteit normaliseert
Je AI-tool moet dezelfde klant kunnen koppelen via e-mail, chat en CRM-records. Dit vereist een uniforme klantidentificatie (meestal e-mail of account-ID) en de mogelijkheid om interactiegeschiedenis samen te voegen. Zonder dit zal je AI lijden onder dezelfde contextresets als je menselijke medewerkers. Successly handelt deze normalisatie automatisch af, maar als je intern bouwt, begroot dit dan als een niet-onderhandelbare vereiste.
Stap 4: Automatiseer kennistoegang en ticketdeflectie
Zodra de identiteit is verenigd, verbind je je kennisbank, productdocumentatie en troubleshootingshandleidingen met de AI-laag. Configureer de AI om veelgestelde vragen te beantwoorden met volledige context, niet alleen met zoekwoorden. Meet vervolgens deflectie, CSAT en bespaarde medewerkerstijd. Itereer op de antwoorden op basis van feedbackloops waarin medewerkers de antwoorden van de AI kunnen corrigeren of verbeteren.
Stap 5: Breid uit naar complexere workflows en cross-functionele context
Nadat je waarde op één gebruiksscenario hebt bewezen, breid je uit naar complexere tickettypen: abonnementswijzigingen, technische troubleshooting, churnrisico-interventies. Breng in dit stadium productgebruiksgegevens en factureringsgeschiedenis in, zodat de AI proactief problemen kan identificeren voordat klanten contact opnemen. Dit is waar de echte omzetbescherming begint.
ROI meten: hoe succes eruitziet met uniforme klantdata
ROI-gesprekken met financiën vereisen meer dan 'betere klantervaring'. Je hebt meetgegevens nodig die gekoppeld zijn aan kostenreductie, omzetbehoud en productiviteit. Dit is wat je moet bijhouden wanneer je datasilo's doorbreekt met AI-supportautomatisering.
Kostenbesparingsmetrieken
-**Eerste responstijd (FRT):**Van uren naar minuten. Snellere FRT vermindert vervolgcontacten en verbetert CSAT. -**Gemiddelde afhandeltijd (AHT):**Lagere AHT betekent dat medewerkers meer tickets per dienst oplossen. Typische reductie: 30–50%. -**Ticketdeflectiepercentage:**Het percentage tickets dat zonder menselijke interventie wordt opgelost. Uniforme context kan dit van 10–15% naar 40–60% tillen. -**Kosten per ticket:**Het gecombineerde effect van lagere AHT en hogere deflectie verlaagt de kosten per ticket doorgaans met 40–60%.
Omzet- en retentiemetrieken
-**CSAT en NPS:**Hogere consistentie drijft tevredenheid. Bedrijven die van silo-support naar uniforme support gaan, zien vaak CSAT stijgen van de lage 70 naar 90+. -**Klantretentiepercentage:**Minder frustrerende ervaringen betekent lagere churn. Zelfs een verbetering van 1–2% in retentie kan miljoenen waard zijn voor een SaaS-bedrijf. -**Expansie-omzet:**Wanneer support volledige context heeft, kunnen medewerkers upsell- en cross-sellkansen natuurlijk identificeren, zonder opdringerig te zijn.
Operationele efficiëntiemetrieken
-**Inwerktijd van medewerkers:**Nieuwe medewerkers komen sneller op snelheid wanneer AI voorgestelde antwoorden en context biedt in plaats van het memoriseren van zes tools te vereisen. -**Escalatiepercentage:**Minder escalaties naar niveau 2/3 omdat niveau 1 betere context en AI-assistentie heeft. -Medewerkerstevredenheid: Supportmedewerkers rapporteren hogere werktevredenheid wanneer ze niet worden gedwongen om menselijke integratoren te zijn die data tussen systemen kopiëren.
Je kunt niet automatiseren wat je niet kunt zien. Geünificeerde data is de voorwaarde voor AI, niet de bijzaak. Bedrijven die dataintegratie behandelen als een eersteklas investering, ontgrendelen een samengesteld rendement op het gebied van deflectie, klanttevredenheid en retentie.
Veelvoorkomende valkuilen bij het uitrollen van AI op basis van versnipperde data
Zoals bij elke technologie is het faalpercentage hoog wanneer fundamentele problemen worden genegeerd. Hier zijn de meest voorkomende valkuilen en hoe je ze kunt vermijden.
Valkuil 1: Automatiseren voor het verenigen
Het inzetten van AI-chatbots die alleen toegang hebben tot een statische FAQ is als het aannemen van een briljante medewerker en hem blinddoeken. De AI geeft algemene antwoorden, frustreert klanten en creëert meer werk voor menselijke medewerkers. Verenig altijd eerst de context, automatiseer daarna.
Valkuil 2: De menselijke overdracht negeren
Zelfs de beste AI deflecteert slechts 40–60% van de tickets. De overige tickets hebben een naadloze overdracht nodig naar menselijke medewerkers met volledige context. Als je AI en helpdesk geen data delen, heb je simpelweg het silo verplaatst. Ontwerp eerst het escalatiepad.
Valkuil 3: Data-unificatie behandelen als een eenmalig project
Databronnen evolueren. Er komen nieuwe tools bij, API's veranderen en klantreizen verschuiven. Geünificeerde data vereist doorlopend onderhoud. Wijs een data-beheerder aan of gebruik een AI-platform dat automatisch context synchroniseert en normaliseert over aangesloten systemen.
Valkuil 4: Activiteit meten in plaats van resultaten
Vier niet het "aantal AI-gesprekken" als die gesprekken geen tickets oplossen of de klanttevredenheid verbeteren. Meet deflectiepercentage, oplossingspercentage, klanttevredenheid en tijd tot oplossing. Dit zijn de metrics die verbinding maken met omzet.
Conclusie: Breek silo's op, schaal vervolgens met AI
Versnipperde data is niet alleen een IT-hoofdpijn, het is de belangrijkste barrière tussen jouw klanten en de naadloze ervaringen die zij eisen. Met 79% van de klanten die consistentie verwachten en 55% die het gevoel hebben dat ze met aparte bedrijven praten, is de kloof groot genoeg om klantverloop te veroorzaken en omzet weg te lekken. De $2,94 biljoen die op het spel staat door slechte klantervaringen zou voldoende moeten zijn om data-unificatie een prioriteit op bestuursniveau te maken.
De weg vooruit vereist geen grootschalige vervanging. Door AI-ondersteuningsautomatisering in te zetten die bovenop je bestaande stack werkt en klantcontext in realtime verenigt, kun je oplossingstijden verkorten, deflectiepercentages verhogen en omzet beschermen. Successly is hiervoor ontworpen: het verbindt je tools, normaliseert identiteit en automatiseert ondersteuning met volledige context, zodat je team stopt met het zijn van menselijke integratoren en begint met het zijn van drijvende krachten achter klantsucces.
Breek de silo's. Ontgrendel de context. Zie je klanttevredenheid stijgen en je kosten per ticket dalen.
Wil je zien hoe Successly jouw ondersteuningsdata verenigt en omzet in directe klantwaarde?
Boek vandaag nog een demo en ontvang een gratis silo-audit voor jouw klantondersteuningsstack.